AI-vänlig webb enligt Äventyret
Så bygger vi en webb där både människor och AI-tjänster får rätt svar, och där du alltid kan visa varifrån svaret kommer.
Fråga en AI-tjänst vad som gäller, så får du svar på en sekund. Snabbt, välformulerat och säkert. Men stämmer det?
En AI-vänlig webbplats är en webbplats där svaret på den frågan är ja. Innehållet är så strukturerat, ägt och aktuellt att både människor och AI-tjänster kan förstå det, återge det rätt och använda det för att vägleda. Och den som står bakom webbplatsen kan alltid visa varifrån ett svar kommer och vem som står för det. Det låter som teknik, men det handlar mest om innehåll och ansvar.
Principerna gäller alla som har en webbplats, företag lika väl som myndigheter. För att göra det konkret tar vi ändå en myndighet som exempel, eftersom kraven är högst där: svaren ska vara rätt, gå att spåra till en rättslig grund och fungera för alla. Ett företag kan förhålla sig friare och plocka det som passar. Frågorna är desamma.
Samma sak på fem ställen
Du känner säkert igen det. Samma uppgift finns på webben, i en pdf från 2019, i chattens kunskapsbas och i kundtjänstens stödtexter. Någon uppdaterar webben, och pdf:en blir kvar. Förr eller senare säger kopiorna olika saker.
Du kanske uppmärksammar inkonsekvensen och ringer eller mejlar och frågar vad som gäller. En AI-tjänst ringer inte, och mejlar inte. Den väljer en version och levererar den lika självsäkert som en väderprognos, med myndigheten som källa. Sedan sprids svaret vidare.
För en myndighet är det mer än ett kommunikationsproblem. Ett felaktigt AI-svar som bygger på en myndighets information kan få allvarliga följder. Någon missar en tidsfrist och förlorar sin rätt att överklaga. Någon betalar fel belopp. Någon låter bli att söka ett stöd som hen har rätt till. Korrekthet är en fråga om rättssäkerhet och förtroende.
Chatten är inte lösningen
Det ligger nära till hands att lansera en chatt. ”Fråga vår AI-assistent!” Men en chatt som bygger på otydligt, motstridigt eller inaktuellt innehåll rättar inte felen. Den förstärker dem, nu med vänlig ton och myndighetens logga.
Det är innehållet och förvaltningen som gör en webbplats AI-vänlig. Varje uppgift ska kunna spåras till en ansvarig ägare och, där det behövs, till en rättslig grund. På Äventyret brukar vi sammanfatta det i två regler: en fråga, ett svar, en ägare. Och ingen ägare, ingen publicering.
Två saker till hör till bilden. Webben ska fungera för alla. Oavsett om man promptar sig fram till informationen eller inte ska webbplatsen vara minst lika bra för den som läser själv, använder skärmläsare eller behöver lättläst. Och maskinerna är redan här. Företag lämnar uppgifter från system till system, ofta via ombud och redovisningsbyråer. De är i praktiken myndighetens första maskinella användare, sedan lång tid tillbaka.
En källa, många fönster
Äventyrets lösning är att myndigheten samlar sin kunskap i en gemensam källa som den själv äger. Där finns strukturerad kunskap om vad som gäller och strukturerade processer som beskriver hur det går till. Webbplatsen blir ett av flera fönster mot källan, bredvid den egna chatten och guidningen, kundservicens stöd, öppna gränssnitt och externa AI-tjänster.
När något ändras, ändras det en gång. Och det blir rätt överallt.
Källan behöver inte vara ett nytt system. Det handlar om hur innehållet struktureras, ägs och förvaltas, och det ska fungera oavsett plattform. Kort sagt: myndigheten bestämmer själv över sin kunskap, sina processer och sin data, vilka AI-tjänster och leverantörer den än använder. Det är det som kallas rådighet. AI-tjänsterna kommer och går. Källan stannar.
Minsta möjliga svar
Byggstenen är svarsenheten: det minsta svaret som går att förstå på egen hand, på en fråga som användare faktiskt ställer. Frågorna hittar du i sökloggar, kundservicens ärenden, chattloggar och användarintervjuer. Inte i organisationsschemat.
Svaret kommer först. Rubriken är frågan, första meningen är svaret, och sedan följer förklaring, villkor och undantag. Många texter börjar från andra hållet, med bakgrunden. Villkoren står i samma enhet som svaret, eftersom AI-tjänster gärna lyfter ut enskilda stycken medan människor läser i sammanhang. Klarspråk får aldrig tappa villkor.
Varje svar bär också med sig uppgifter om sig självt: vem som äger det, vem som har granskat det, vad det vilar på och hur länge det gäller. Lite som bäst före-datumet på mjölken, fast med en ansvarig utgivare. Fullt ut handlar det om ägare, sakgranskare, rättslig grund, målgrupp, giltighet, senaste och nästa granskning, status och version. Uppgifterna syns både för människor (”Senast granskad …”) och för maskiner.
Enheterna hänger ihop. Begrepp länkas till regler, regler till processer, processer till tjänster och nya versioner till dem de ersätter. Då kan en AI-tjänst följa kedjan från fråga till rättslig grund, och myndigheten ser direkt vad som påverkas när något ändras. Språkversioner, lättläst och teckenspråk är varianter av samma enhet, med samma ägare och giltighet. Ändras originalet flaggas varianterna, så att ingen version blir kvar med gammal information.
Så här kan en svarsenhet se ut, med frågan om hur lång tid man har på sig att överklaga ett beslut som exempel.
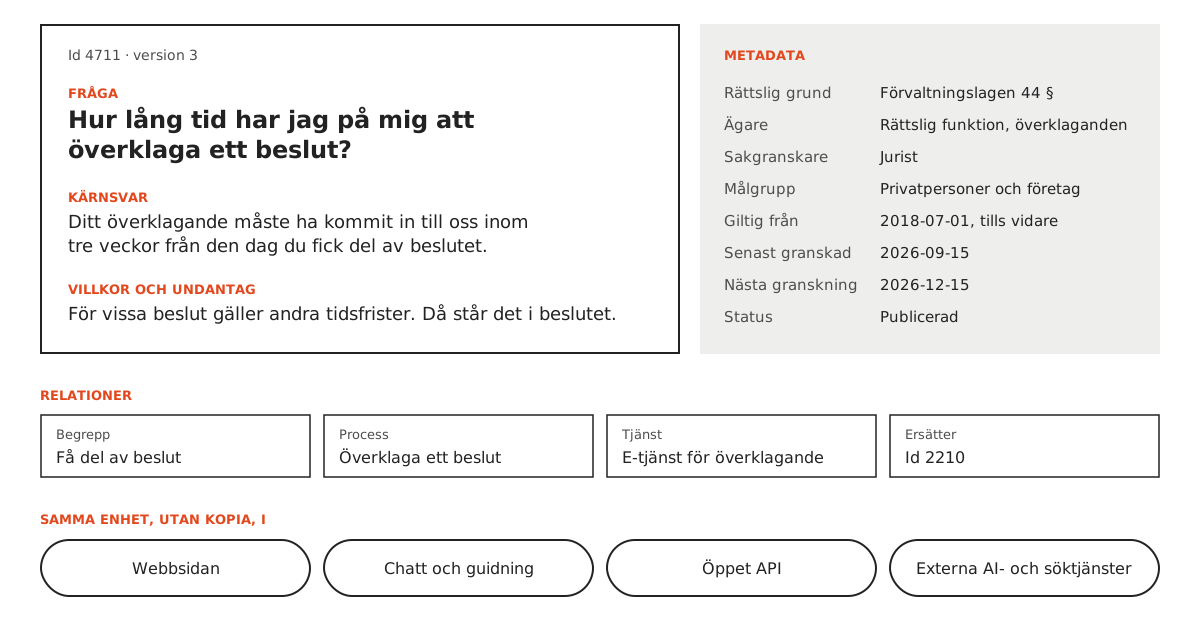
Ett svar, en ägare, många kanaler. Exempel på en svarsenhet: det minsta svaret som går att förstå på egen hand.
Samma enhet används sedan på fyra sätt, utan att kopieras:
- Webbsidan. Enheterna sätts ihop till läsbara sidor i semantisk HTML. Allt viktigt ska finnas i själva sidan redan när den kommer från servern. De flesta AI-tjänsters robotar, som GPTBot, OAI-SearchBot, ClaudeBot och PerplexityBot, kör nämligen inte JavaScript och ser därför inte innehåll som laddas först i webbläsaren. Google är undantaget.
- Strukturerad data. Märkning enligt schema.org hjälper maskiner att tolka sidan. Den betyder ändå mindre för synligheten än att innehållet i sig är tydligt.
- Öppet gränssnitt (API). Enheterna med metadata, giltighet och källa, enligt Diggs REST API-profil, för myndighetens egna och andras tjänster.
- Chatt, guidning och kundservice. Bara godkända och giltiga enheter, alltid med källhänvisning.
Processer är också innehåll
Mycket av det som står på en myndighets webbplats beskriver egentligen en process. Hur du ansöker, anmäler, ändrar eller överklagar. Därför beskriver vi processer som modeller: steg, roller, villkor, beslutspunkter, underlag, tidsfrister och statusar, i öppna standarder för flöden och beslutsregler (BPMN och DMN). Varje steg hänvisar till svarsenheterna i stället för att upprepa dem.
Bilden visar hur det kan se ut, med ett ordinärt bygglov uppbyggt i en processbyggare som vi har tagit fram. Faserna läses från vänster till höger, och varje steg, beslut och handling har ett eget id.
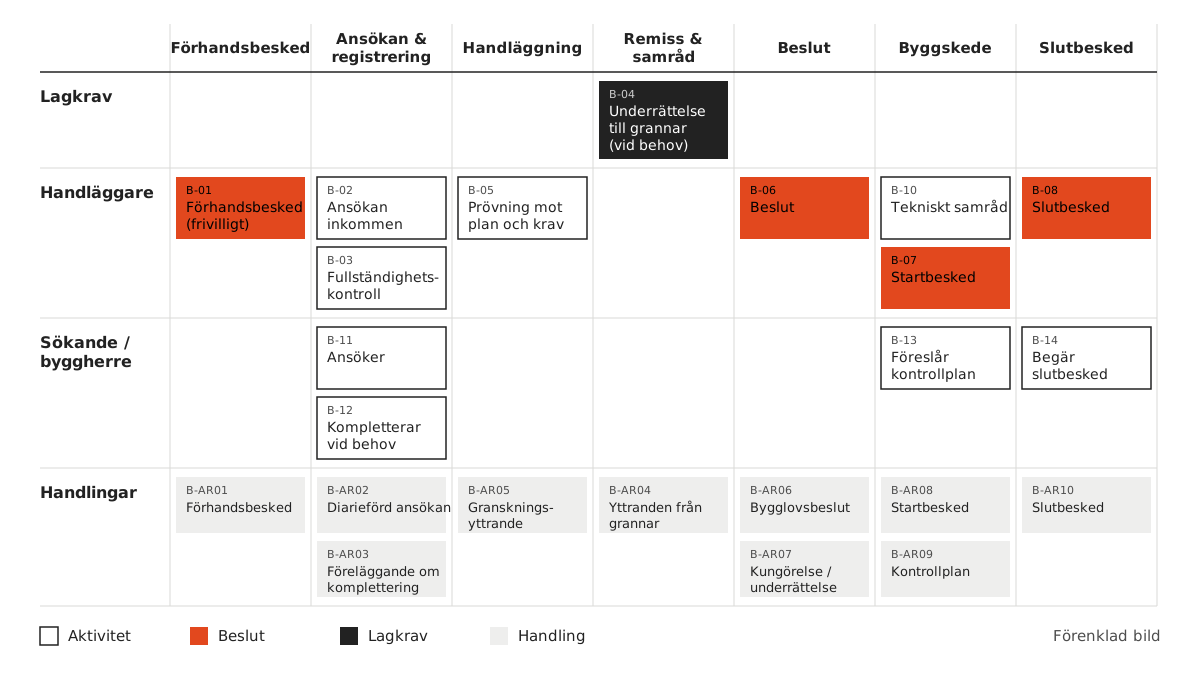
En process som modell, inte som löptext. Exempel: ordinärt bygglov, uppbyggt i en processbyggare där processer blir körbara av både mänskliga och maskinella användare. Visualiseringen är förenklad. När en process ska bli verklighet tar vi in experter, i det här fallet på bygglov.
Varje typ av steg, som att lämna uppgifter, bifoga underlag eller få besked, får ett eget standardiserat och tillgängligt gränssnittsmönster. Människan möter samma logik som AI-tjänsten följer, och nya processer byggs av beprövade delar.
Processer ändras ofta medan ärenden pågår. Därför har varje processversion ett nummer och en giltighetsperiod, och varje ärende knyts till den version det startade i. Då går det alltid att visa vad som låg till grund för ett beslut.
När Google, AI och läsaren vill olika saker
Den goda nyheten först. Sökmotoroptimering (SEO), optimering för svar (AEO eller GEO, att innehållet besvarar frågan så direkt att det kan lyftas in i sök- och AI-svar) och användbarhet vilar till största delen på samma grund: tydliga rubriker, semantisk HTML, klarspråk, alternativtexter och viktig information som text på sidan i stället för i pdf-filer. Tillgänglighet är redan ett lagkrav och gör samtidigt innehållet lättare för maskiner att tolka. Där börjar vi.
Ibland drar målen ändå åt olika håll:
- Fristående svar eller sammanhang? AI-tjänster lyfter ut stycken, människor läser i sammanhang. Vi skriver varje svar så att det bär sig självt och sätter sedan ihop svaren till läsbara sidor. Separata texter för AI skriver vi aldrig.
- Många sidor eller färre och bättre? Snarlika sidor kan ge fler sökträffar, men de ger AI-tjänsterna motstridiga svar, och söktjänsterna nedvärderar massproducerat innehåll. En fråga, ett svar, en ägare.
- Enkelt eller fullständigt? Kärnsvaret först, villkor och undantag direkt efter, rättslig grund länkad.
- Synlighet eller kontroll? AI-leverantörerna har separata robotar för sök, för hämtningar som användaren ber om och för träning, och du styr dem var för sig i robots.txt. OpenAI har till exempel OAI-SearchBot för sök, ChatGPT-User för användarens hämtningar och GPTBot för träning. Stänger du ute OAI-SearchBot syns du inte i ChatGPT:s söksvar, medan den som bara stänger GPTBot syns precis som förut. Robotar som hämtar på användarens begäran följer dock inte alltid robots.txt. På samma sätt styr Google-Extended träningen av Gemini, men tar inte bort webbplatsen ur Googles AI-översikter. Vill du synas i AI-svar tillåter du sök och användarfrågor. Träning är en egen principfråga.
Och om en konflikt ändå kvarstår? Då gäller en fast ordning. Tillgänglighetskraven är ett golv som aldrig sänks. Därutöver går korrekthet före användbarhet, och användbarhet före synlighet.
En sak som ofta dyker upp i de här samtalen är llms.txt, en fil som ska hjälpa AI-tjänster att hitta rätt på webbplatsen. Google har sagt uttryckligen att den inte påverkar sökningen, varken åt ena eller andra hållet, och ingen av de stora AI-söktjänsterna har bekräftat att de använder den. Den kan ändå vara värd att generera ur källan inför steg tre, som en enkel karta för agenter. Men det är ingen synlighetsåtgärd, och den som säljer in den som en sådan har missförstått något.
Ingen ägare, ingen publicering
Ansvaret för innehållet ligger i verksamheten, inte hos webbredaktionen. Innehållsägaren, en chef eller funktion i verksamheten, ser till att innehållet är rätt och aktuellt och beslutar om publicering, ändring och avveckling. Sakgranskaren, till exempel en jurist, kontrollerar att det stämmer rättsligt och sakligt. Redaktören svarar för klarspråk, tillgänglighet, struktur och metadata, och publicerar. Informationsförvaltaren håller ihop modellen, begreppslistan och testfrågorna och följer upp.
Hur ofta ett svar granskas beror på risken: hur många som använder det och vad ett fel kan leda till. Tidsfrister och belopp granskas oftare än annat, och förfallna granskningar flaggas till ägaren.
Mycket av bevakningen kan AI-agenter sköta. De följer ändringar i författningar och beslut, hittar motsägelser och dubbletter, flaggar datum som löper ut och skriver första utkast i klarspråk. Men de beslutar aldrig och publicerar aldrig själva. Agenterna föreslår, människor beslutar.
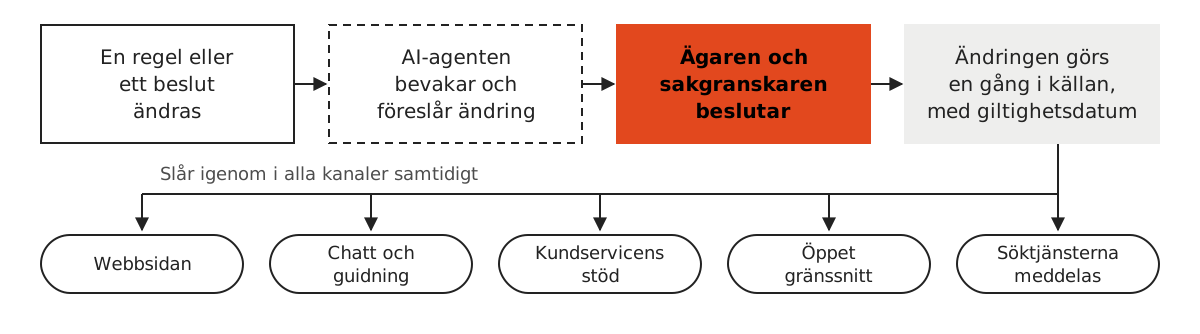
En ändring görs en gång och slår igenom överallt. Agenterna bevakar och föreslår, människor beslutar.
Fel rättas snabbt, och vid källan. Varje svar på webben och i chatten har ett sätt att rapportera fel, och rapporterna går direkt till ägaren. Fel i tidsfrister, belopp och andra rättsligt avgörande uppgifter rättas samma dag, och orsaken följs upp så att felet inte kommer tillbaka.
Och inget försvinner i tysthet. Ett svar som upphör får status och slutdatum, och ”ersatt av” pekar vidare. Gamla adresser leder till det nya svaret eller visar tydligt att innehållet har upphört. Svaret tas bort ur chattens underlag samma dag och söktjänsterna meddelas. Den gamla versionen sparas, så att det går att visa vad myndigheten sa vid en viss tidpunkt.
Egna och andras AI-tjänster
En AI-tjänst som myndigheten själv tar i bruk, egen eller upphandlad, talar med myndighetens röst. Därför styrs den av en säkrad källa och tydliga regler. Den är byggd för att bara svara utifrån godkända och giltiga enheter, visa källa och datum och hålla sig inom myndighetens områden. Den ger aldrig besked i enskilda ärenden, hänvisar till en handläggare när det behövs och är instruerad att hellre säga att den inte vet än att gissa. Och det syns tydligt att det är en AI, i linje med AI-förordningens krav på öppenhet.
Kunskapen tränas inte in i modellen. En tränad modell kan inte uppdateras samma dag som en regel ändras, och den kan inte visa varifrån ett svar kommer. I stället hämtar tjänsten svaret ur källan varje gång någon frågar, det som brukar kallas RAG (retrieval-augmented generation). Här gör svarsenheterna stor skillnad. När varje enhet redan är ett fristående svar med sina villkor hämtar tjänsten hela svaret, inte ett lösryckt stycke.
Men även med rätt underlag kan en språkmodell formulera fel. Därför prövar en fast uppsättning vanliga och kritiska testfrågor svaren före lansering och efter större ändringar. Tjänsten testas också mot försök att lura den utanför sina regler, så kallad promptinjektion.
Andras AI-tjänster kan myndigheten inte styra. Men den har en naturlig fördel: den är den mest auktoritativa källan i sina frågor. Fördelen räknas bara om källan går att hitta och är entydig. Annars citerar AI-tjänsterna andrahandskällor som sällan uppdateras. Så bort med motstridiga dubbletter, låt pdf- och utskriftsversioner peka på webbsidan som original och meddela söktjänsterna ändringar samma dag. Till Bing går det att göra direkt via protokollet IndexNow, och det betyder mer än man kan tro: Bings index används av Copilot och ligger till stor del bakom ChatGPT:s sök. Google stöder inte IndexNow, där gäller i stället uppdaterade webbplatskartor. Testfrågorna visar var tjänsterna svarar fel, så att källan kan förtydligas.
Rådigheten gäller också data. Webbplatsen är offentlig, men det folk skriver i en chatt innehåller ofta personuppgifter, och hos en myndighet är frågorna normalt allmänna handlingar. Egna AI-tjänster bör därför köras där myndigheten bestämmer var data behandlas och hur länge den sparas, och där frågor och svar inte används för att träna modeller. Eftersom källan bygger på öppna standarder kan myndigheten byta AI-modell, även till öppna modeller, utan att bli inlåst hos en leverantör.
Så vet du att det fungerar
Målen sätts innan något ändras. Annars går det aldrig att visa vad arbetet gav. Nivåerna i tabellen är våra utgångspunkter, och de slås fast först när nuläget är mätt. Ett mål utan nuläge är en gissning.
| Mål | Så mäter vi | Utgångspunkt för målnivå |
|---|---|---|
| Korrekta svar | Ett par hundra vanliga och kritiska frågor körs varje månad mot den egna chatten och de största AI-tjänsterna. AI-tjänster svarar inte likadant varje gång, så varje fråga körs flera gånger. Informationsförvaltaren bedömer svaren och sakgranskaren avgör tveksamma fall. | Minst 95 procent korrekta svar med rätt källa i den egna chatten. Ökande andel i externa tjänster. |
| Synlighet i AI-svar | Andel testfrågor där myndigheten anges som källa, kompletterat med söktjänsternas egna rapporter om AI-svar. | Ökning mot nuläget vid varje halvårsuppföljning. |
| Aktuellt innehåll | Andel innehåll med ägare, giltighetsdatum och granskning i tid. Tid från beslutad ändring till rätt svar i alla kanaler. | 100 procent i pilotområdet. Rätt samma dag som ändringen börjar gälla. |
| Tillgänglighet och klarspråk | WCAG 2.2 nivå AA, ett steg över dagens krav (2.1 AA), klarspråk enligt språklagen och användartester. | Inga kända brister på nivå A och AA vid publicering. |
| Användaren klarar sitt ärende | Andel som löser sin uppgift i användartester. Färre kontakter med kundservice i frågor som webben redan besvarar. | Minst 90 procent i pilotområdets tester. |
Synligheten går numera att följa i söktjänsternas egna verktyg. Bing Webmaster Tools har sedan början av 2026 en rapport, ännu i förhandsversion, som visar hur ofta innehållet citeras i Copilot och Bings AI-svar, och vilka sökfraser AI:n själv använde för att hitta det. Google Search Console rullar ut en motsvarande rapport för AI-översikter och AI Mode. Verktygen visar inte allt, men tillsammans med testfrågorna ger de en ärlig bild av var myndigheten står.
Vart det leder: läsbar, guidande, körbar
Vi ser arbetet som en trappa i tre steg. Varje steg ger nytta i sig och lägger grunden för nästa.
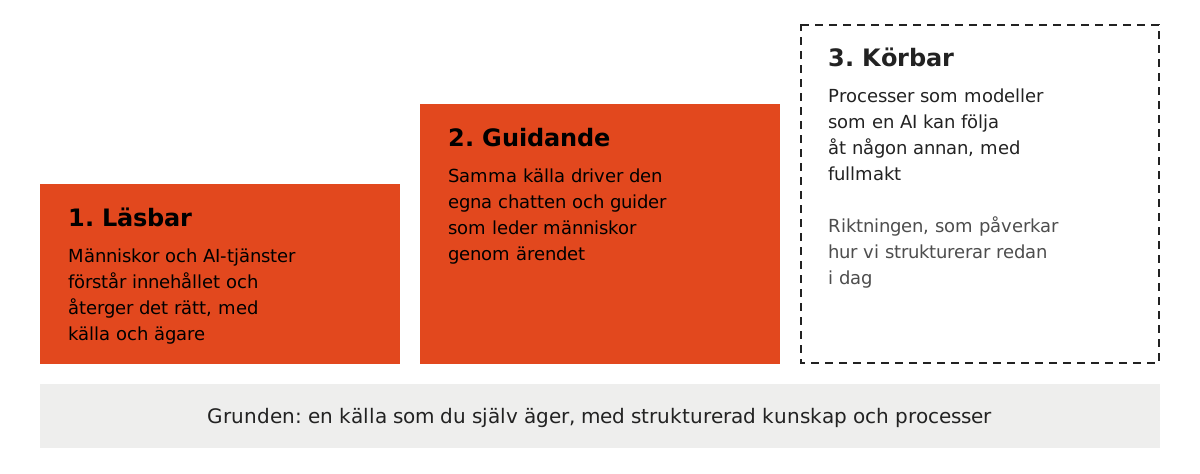
Varje steg ger nytta i sig och lägger grunden för nästa. Från läsbar till guidande och, på sikt, körbar.
Steg tre gör myndigheten redo för det som ofta kallas den agentiska webben. Där utför AI-assistenter uppgifter åt människor i stället för att bara svara på frågor. Tänk dig en företagare som ber sin AI-assistent att överklaga ett beslut. Finns processen som en maskinläsbar modell, och går den att nå genom ett öppet gränssnitt, behöver assistenten inte gissa. Ett sådant gränssnitt kan till exempel byggas med MCP (Model Context Protocol), som många AI-assistenter i dag använder för att anropa tjänster. Den kan kontrollera fristen, samla rätt underlag och lämna in rätt, med fullmakt från företagaren och spårbarhet för myndigheten. Juridiskt är det fortfarande företagaren som agerar, och assistenten är hennes verktyg.
En myndighet som är redo för agenter bygger alltså inte egna agenter. Den ser till att regler och processer går att följa korrekt även när en AI gör det åt någon annan. Identitet och fullmakter hanteras med e-legitimation. Hos myndigheterna tillkommer SverigeID, den statliga e-legitimationen som lanseras den 1 december 2026 och som ska ingå i den statliga digitala identitetsplånboken. Längre fram kommer också den företagsplånbok som EU har föreslagit. I båda fallen lämnar du bara de uppgifter som behövs. Steg tre är riktningen, och den påverkar hur vi strukturerar redan i dag.
Var börjar man?
Med ägarskapet, inte tekniken. Ett svar utan ägare publiceras inte.
Mät innan du ändrar. Kör ett par hundra vanliga och kritiska frågor mot den egna chatten och de största AI-tjänsterna, så att du vet var du står. Börja där nyttan och risken är störst, med det innehåll som används mest och där fel får störst konsekvenser, gärna i ett avgränsat pilotområde med stabil rättslig grund. Och använd det som redan finns: innehåll, plattform och begrepp.
Så här ser ett typiskt upplägg ut. Först en förstudie där vi inventerar innehåll och ägarskap, analyserar verkliga frågor från privatpersoner, företag och ombud, mäter nuläget och väljer pilot. Parallellt tar vi fram modellen för innehåll och förvaltning tillsammans med verksamheten. Sedan en pilot där ett avgränsat område skrivs om till svarsenheter, en process modelleras och ändringens väg prövas skarpt. Tillsammans tar det ungefär sex månader. Efter förstudien och efter piloten beslutar ledningen om att gå vidare, utifrån uppmätt effekt. Därefter förs övriga områden över ett i taget, tills myndigheten förvaltar på egen hand.
Det du får är i första hand inte en ny webbplats. Det är en källa som du själv äger och som både människor och AI kan lita på. Webbplatsen blir ett av fönstren mot den.
Vi gör redan så här
Det här är inte bara en idé. Åt en regional offentlig förvaltning har Äventyret gjort processerna för bidragsansökningar körbara. Åt ett internationellt private equity-bolag har vi gjort samma sak med processerna för hela affärsverksamheten. Och för en branschorganisation som ger juridisk rådgivning har vi tagit fram innehållsprinciper, en förvaltningsmodell och ett sök som i dag driver en AI-assistent i skarp drift.
Samtidigt utvecklar vi, tillsammans med kommuner och regioner och i dialog med nationella myndigheter, en generell modell för körbara offentliga processer. Processbyggaren i bilden ovan är en del av det arbetet. Vi är också expertkonsulter på EU-nivå i processtyrning i offentlig sektor.
Äventyret använder också AI-agenter i det egna arbetet. I innehållsarbetet hjälper de till med inventering, första omskrivning till svarsenheter och körning av testfrågorna. I teknikproduktionen, när vi bygger webbplatser, tjänster och integrationer, arbetar utvecklarna med AI-agenter som skriver, granskar och testar kod. Samma regel gäller överallt, hos oss som hos våra kunder: agenten föreslår, människan beslutar. Det gör arbetet snabbare utan att ansvaret flyttas.
Vill du ha hjälp av några som redan har gjort det här? Ring eller mejla oss. Det kan ju du, till skillnad från en AI-tjänst.
Uppgifterna om AI-tjänster och sökverktyg i texten gäller hösten 2026, när den här artikeln publicerades. Det här området ändras snabbt.